Big Data
Kursus: Big Data | LearnSpace
-
-
I det her fag vil vi kigge på hvad det vil sige når vi taler om Big Data.
Når vi skal behandle datakilder hvor data kommer strømmende kontinuerligt, med stor hastighed, og til tider i meget store mængder, kan vi ikke bruge vore klassiske IT værktøjer til at behandle dem. Der skal istedet benyttes løsninger der er specifikt beregnet til, at håndtere disse data strømme.
Du kommer til at kende kende til begreber, datatyper og -formater som typisk indgår i Big Data løsninger, og kommer til at arbejde med distribuerede teknologier som sætter os i stand til at udtrække relevante datastrukturer og efterbehandle dem så de kan indgår som beslutningsgrundlag, eller til videre behandling i IT systemer. -
I første lektion skal vi have en fælles forståelse af begrebet Big Data. Vi skal tage den indledende diskussion om hvad "Big" i "Big Data" handler om.
-
I første lektion lægger vi ud med en Padlet. Her skal I beskrive hvad Big Data er med jeres egne ord.
-
-
-
I denne lektion skal vi lære om volume og velocity. Vi skal kunne skelne dem fra hinanden og diskutere, hvilken af dem, der er vigtigst.
-
Data er meget, meget mere end relationelle databaser. Udover volume og velocity skal en data engineer forstå forskellen på forskellige dataformater. Data kan variere voldsomt. I denne lektion taler vi om strukturerede, semi-strukturerede og ustrukturerede data. Når vi overvejer om data er struktureret eller ustruktureret taler vi om analyseværdien af data.
-
-
-
-
-
Åbnet: mandag den 24. januar 2022, 00:00Studerende skalAflever en besvarelse
-
-
Behandling af data medfører en risiko for, at data bliver misbrugt. Derfor medfølger der et juridisk ansvar for at behandle andres data. I Big Data behandler vi rigtig meget data.
-
I denne lektion diskuterer vi hvordan vi sikrer at vores analyser er baseret på det rette data.
-
Data Governance drejer som om virksomhedens strategi for datahåndtering og hvordan strategien håndhæves. Med tiden bliver data irrelevant, bør man så beholde den? Vi skal tale om defensive og offensive strategier, samt domænespecifikke vs Master data management.
-
Dette afsnit omhandler hvordan Hadoop løser vores problem med store og hurtige tilstrømmende datamængder ved, at distribuere opgaven på et større antal hosts. Hadoop et distribueret system hvor vi kan bahendle filer, som om de findes på en enkelt disk, selvom de er fordelt på mange computere i et netværk.
De linkede kurser kræver et Pluralsight abbonnement.
The Building Blocks of Hadoop - HDFS, MapReduce, and YARN
https://app.pluralsight.com/library/courses/building-blocks-hadoop-hdfs-mapreduce-yarn/table-of-contents
OBS! Hop over delen med stand-alone udgavenUnderstanding Hadoop's Distributed File System
https://app.pluralsight.com/guides/understanding-hadoop's-distributed-file-systemGetting Started with Hadoop MapReduce
https://app.pluralsight.com/guides/getting-started-with-hadoop-mapreduce-
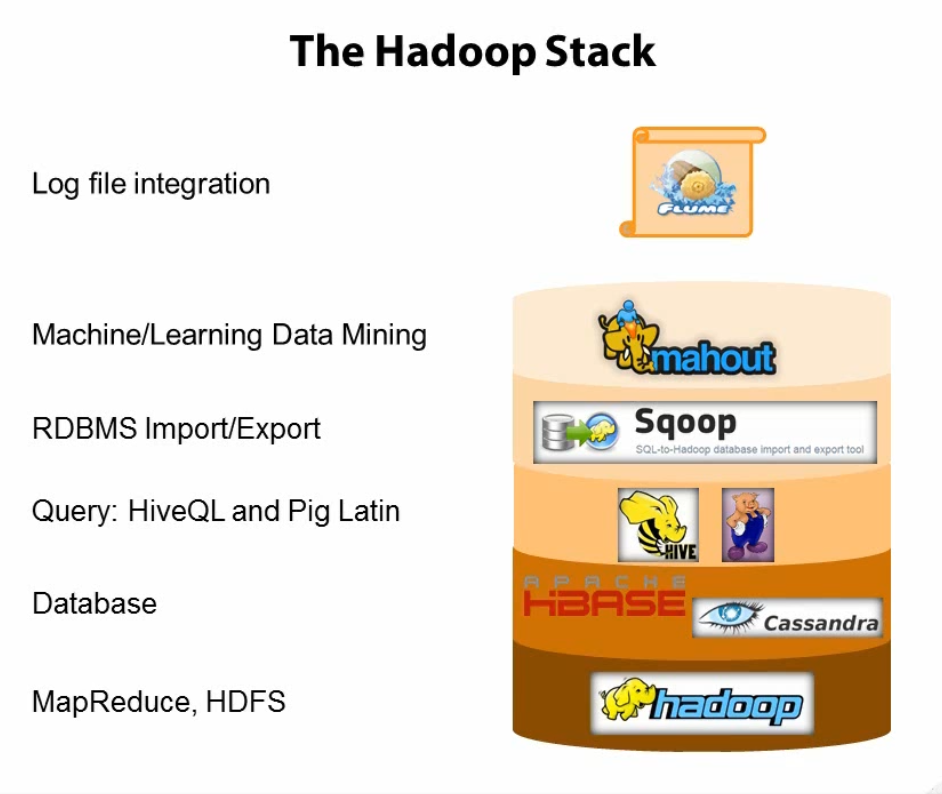
HADOOP er et Apache projekt der kombinerer MapReduce funktionalitet med HADOOP Distibuted File System (HDFS). HADOOP er en Open Source implementering af Googles MapReduce løsning (filsystemet hedder her GFS).
HDFS(GFS) tillader os at tilgå filer, som er på flere forskellige maskiner (Nodes), som et samlet filsystem. Datene replikeres på yderligere 2 af noderne, så der opnåes en vis fejlresistens.HADOOP udgør det nederste lag der giver adgang til dataene. For at opnå målene vi har med at benytte big data, er der et antal lag af yderligere software teknologier, vi lægger ovenpå for, at kunne arbejde med dataene.
-
MapReduce beskriver processen hvor de indkommende datastrømme indekseres på en måde, så det bliver muligt for os at søge i data, og udtrække relevante data fra datastrømmende.
-
Review of MapReduce
The MapReduce framework is the basis for the majority of data-intensive frameworks today. The following diagram illustrates a basic MapReduce wordcount process.
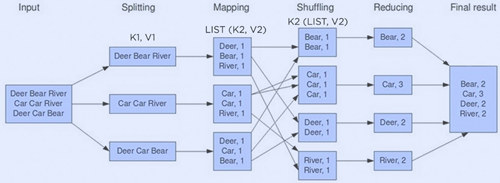
The corpus of text is first separated into the initial <key,value> pair. With text as the input, the initial <key,value> pair is the line and the contents of the line. Afterwards, the mapper function divides those initial <key,value> pairs into intermediate key value pairs. In this case, each instance of a word is mapped to the value 1. The shuffle phase then sorts each of the <key,value> pairs by key, so that the reducer can take care of aggregating the pairs for the final result.
-
Apache Kafka, er en af de løsninger en virksomhed kan vælge at benytte til, at håndtere Big Data.
Kafka giver mulighed for, at man lader alle virksomhedens data blive samlet i et centralt Kafka system, der behandler data som data strømme.
Kafka betragter systemerne som enten data consumere eller data prodicere. Det er på den måde muligt, at sammenkoble data, af alle typer fra flere forskeliige IT systemer, og på den måde danne nye og vigtige data, der kan benyttes som beslutningsgrundlag i vigtige forretnings processer.
For at dette fungerer optimalt, er det muligt i Kafka at lave et data registry hvori man beskriver alle de data der findes i virksomhedens IT systemer, og her også forholder sig til hvilken type data det drejer sig om.
Man kan benytte ind til flere programmerings sprog til, at sammenkoble og efterbehandle data der trækkes ud af Kafka, og disse data kan igen fodres ind i Kafka systemet igen.
Kafka system persisterer virksomhedens data, og har redundans der sikrer imod data tab.